基于Python的商品销售数据实时分析与可视化大屏 营收大数据分析实践
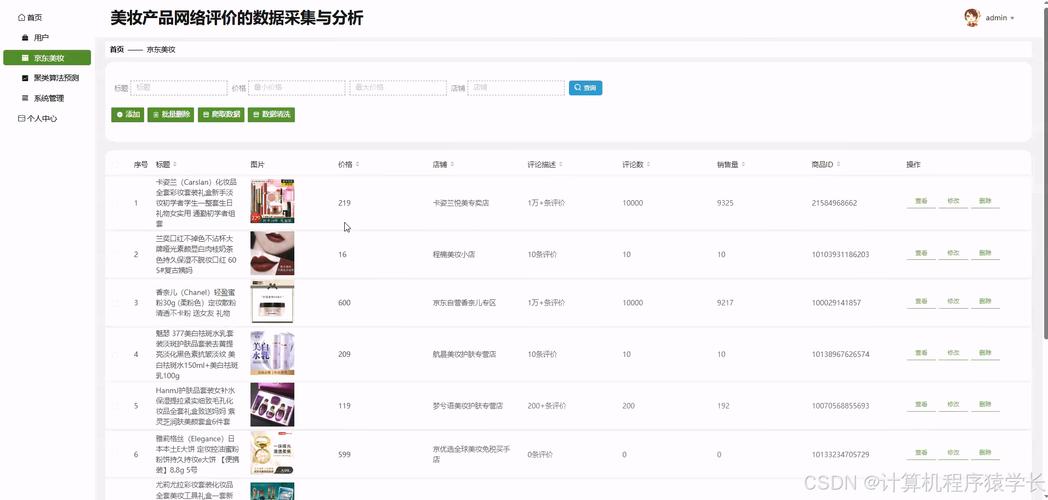
在数字化零售时代,商品销售数据的实时分析与可视化已成为企业决策的核心驱动力。本文介绍如何利用Python构建一个实时销售数据分析与可视化大屏,重点聚焦营收数据的多维度洞察,实现大数据价值的高效转化。
1. 系统架构概述
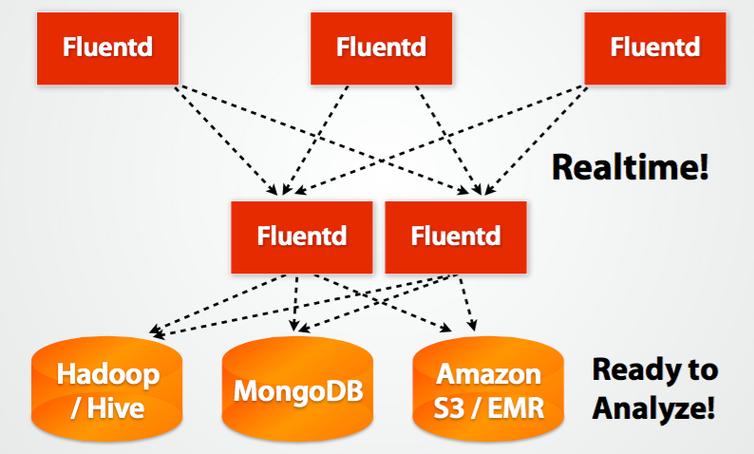
整个系统分为数据采集、实时处理、数据存储、分析与可视化五大模块。数据源可来自订单数据库、日志文件或消息队列(如Kafka)。使用Python的pandas、Apache Spark(PySpark)进行流式与批处理计算,将结果存入Redis或PostgreSQL供大屏实时读取。可视化层面采用Dash或Streamlit构建交互式大屏,支持动态刷新。
2. 实时数据处理流程
通过Kafka Consumer或Flask API接收实时订单流,使用PySpark Structured Streaming或pandas进行微批处理,计算每分钟/每小时的销售额、订单量、客单价等核心指标。处理后的聚合结果以时间序列形式写入时序数据库(如InfluxDB)或高速缓存,确保大屏可以秒级延迟展示最新营收状况。
3. 营收数据分析关键指标
- 总营收与趋势:实时累计销售额,并按小时/天绘制趋势线,识别销售高峰。
- 品类/商品营收贡献:使用堆叠柱状图或树图展示各品类营收占比,定位爆款与滞销品。
- 区域营收分布:基于地图可视化(如Pyecharts)展示各省/城市销售额,辅助区域策略调整。
- 同比/环比增长:计算与历史同期对比的增长率,动态监控业绩健康度。
- 客单价与转化率:结合订单数据计算平均客单价、转化漏斗,评估营销效果。
4. 可视化大屏实现
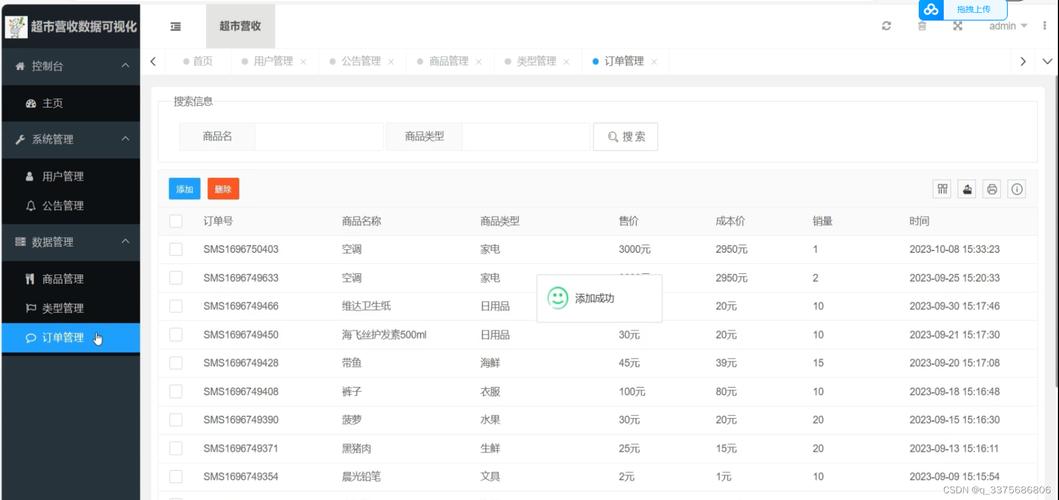
采用Dash框架搭建Web大屏,利用Plotly绘制交互式图表。大屏布局包含:顶部KPI卡片(总营收、今日订单、同比增长率)、左侧品类销售排行、中间营收趋势动态折线图、右侧区域销售地图、底部实时订单流水表。通过WebSocket或定时回调实现数据自动刷新。为提升性能,可使用Redis缓存聚合结果,并采用Celery异步更新。
5. 技术栈与大数据工具
- 数据处理:pandas, PySpark, NumPy
- 数据存储:Redis, PostgreSQL, InfluxDB
- 可视化:Dash, Plotly, Pyecharts, Streamlit(备选)
- 实时流:Kafka, WebSocket
- 部署:Docker, Gunicorn, Nginx
6. 应用价值与
基于Python的商品销售实时分析大屏能够帮助企业即时掌握营收动态,快速发现异常与机会,驱动数据化运营。通过整合大数据处理与可视化技术,企业可以低成本构建敏捷的分析体系,为精准营销、库存优化和战略决策提供有力支撑。
如若转载,请注明出处:http://www.jianqunge168.com/product/42.html
更新时间:2026-11-01 02:42:25